模型评估方法
对于一个包含\(m\)个样例的数据集\(D=\{(x_i,y_i)|i=1,2,\cdots,m\}\),我们可以通过对\(D\)进行一定处理,从中产生训练集\(S\)和测试集\(T\)分别进行测试和评估.
留出法(hold-out)
留出法即将数据集划分为两个互斥的集合\(S\)(数据集)以及\(T\)(测试集),满足:
\[
\begin{cases}
S\cup T=D\\
S\cap T=\emptyset
\end{cases}
\]
在使用\(S\)训练出模型之后用\(T\)来评估其测试误差.
该方法最好使用数据集中大约\(67\%\sim80\%\)样本作为训练数据,其余用于测试,并且在使用该方法时需要采用若干次随机划分、重复进行实验评估后取平均值作为评估结果.
交叉验证法(cross validation)
交叉验证法即将数据集\(D\)划分为\(k\)个大小相似的互斥子集\(D_i(i=1,2,\cdots,k)\),满足:
\[
\begin{cases}
D_1\cup D_2\cup\cdots\cup D_k=D\\
D_i\cap D_j=\emptyset, i\neq j
\end{cases}
\]
每个子集都尽可能保持数据分布的一致性,之后每次采用\(k-1\)个子集的并集作为训练集,并用剩下一个子集作为测试集,这样就可以得到\(k\)组训练集和测试集:
\[
\begin{cases}
\text{组\(1\)}:&
\begin{cases}
S=D_2\cup D_3\cup\cdots\cup D_k\\
T=D_1
\end{cases}\\
\text{组\(2\)}:&
\begin{cases}
S=D_1\cup D_3\cup\cdots\cup D_k\\
T=D_2
\end{cases}\\
\text{组\(3\)}:&
\begin{cases}
S=D_1\cup D_2\cup D_4\cup\cdots\cup D_k\\
T=D_3
\end{cases}\\
\cdots\\
\text{组\(k-1\)}:&
\begin{cases}
S=D_1\cup D_2\cup\cdots\cup D_{k-2}\cup D_k\\
T=D_{k-1}
\end{cases}\\
\text{组\(k\)}:&
\begin{cases}
S=D_1\cup D_2\cup\cdots\cup D_{k-1}\\
T=D_k
\end{cases}\\
\end{cases}
\]
进行\(k\)次测试验证后对测试结果取平均作为评估结果。对于任一组,训练集和测试集同样满足\(S\cup T=D,S\cap T=\emptyset\),通常将交叉验证法称为\(k\)折交叉验证(常取\(k=10\)).
自助法(bootstrapping)
这种方法是以自主采样法(bootstrap sampling)为基础的:
对于一个包含\(m\)个样本的数据集\(D\),对它采样产生数据集\(D’\)(采样方法为\(m\)次有放回随机采样),可以知道任意一个样本\(s\in D\)始终没有被采样到的概率为:
\[
\left(1-\frac{1}{m}\right)^m
\]
有:
\[
\lim_{m\rightarrow\infty}\left(1-\frac{1}{m}\right)^m=\frac{1}{e}\approx0.368
\]
可以知道数据集\(D\)中有大约\(36.8\%\)的样本不会被采样到,所以我们可以用\(D’\)作为训练集,\(D-D’\)作为测试集进行训练和测试.
自助法适合在数据集较小、难以有效划分训练集和测试集的时候比较有用,在数据量足够大的时候最好使用留出法或交叉验证法
线性模型
给定由\(d\)个属性描述的示例\(\pmb{x}=(x_1,x_2,\cdots,x_d)^T\),其中\(x_i\)为\(\pmb{x}\)在第\(i\)个属性上的取值,线性模型试图学得一个关于\(\pmb{x}\)的线性函数来进行预测的函数:
\[
f(\pmb{x})=w_1x_1+w_2x_2+\cdots+w_dx_d+b
\]
向量表示为:
\[
f(\pmb{x})=\pmb{w}^{T}\pmb{x}+b
\]
其中\(\pmb{w}=(w_1,w_2,\cdots,w_d)^T\),在\(\pmb{w}\)和\(b\)学得之后,模型就可以确定.
线性回归
给定数据集\(D=\{(\pmb{x}_i,y_i)|i=1,2,\cdots,m\}\),其中\(\pmb{x}_i=(x_{i1},x_{i2},\cdots,x_{id})^T,y_i\in\mathbb{R}\),线性回归试图学得一个线性模型以尽可能准确地预测实值输出标记,可采用多元线性回归算法来试图学得函数\(f(\pmb{x})\)使得:
\[
f(\pmb{x}_i)=\pmb{w}^{T}\pmb{x}_i+b\simeq y_i
\]
多元线性回归采用最小二乘法来对\(\pmb{w}\)以及\(b\)进行估计,算法如下:
首先将数据集\(D\)表示为一个\(m\times(d+1)\)的矩阵\(\pmb{X}\):
\[
\pmb{X}=\left(\begin{matrix}
x_{11}&x_{12}&\cdots&x_{1d}&1\\
x_{21}&x_{22}&\cdots&x_{2d}&1\\
\vdots&\vdots&\ddots&\vdots&\vdots\\
x_{m1}&x_{m2}&\cdots&x_{md}&1
\end{matrix}\right)=\left(\begin{matrix}
\pmb{x}_1^T&1\\
\pmb{x}_2^T&1\\
\vdots&\vdots\\
\pmb{x}_m^T&1
\end{matrix}\right)
\]
并将标记\(y_1,y_2,\cdots,y_{m}\)写成向量形式\(\pmb{y}=(y_1,y_2,\cdots,y_{m})^{T}\),有\(\pmb{w}\)的近似向量:
\[
\hat{\pmb{w}}^{*}=(\pmb{X}^{T}\pmb{X})^{-1}\pmb{X}^T\pmb{y}
\]
令\(\hat{\pmb{x}}_i=(\pmb{x}_i^{T},1)^T\)(即在\(\pmb{x}_i\)的最后拼上一个\(1\)),可以得到一个多元线性回归模型:
\[
f(\hat{\pmb{x}}_i)=\hat{\pmb{x}}_i^T\hat{\pmb{w}}^{*}=\hat{\pmb{x}}_i^T(\pmb{X}^{T}\pmb{X})^{-1}\pmb{X}^T\pmb{y}
\]
这里以加利福尼亚房屋价格数据集为例,该数据集描述如下:
.. _california_housing_dataset:

California Housing dataset
--------------------------

**Data Set Characteristics:**

:Number of Instances: 20640

:Number of Attributes: 8 numeric, predictive attributes and the target

:Attribute Information:
    - MedInc        median income in block group
    - HouseAge      median house age in block group
    - AveRooms      average number of rooms per household
    - AveBedrms     average number of bedrooms per household
    - Population    block group population
    - AveOccup      average number of household members
    - Latitude      block group latitude
    - Longitude     block group longitude

:Missing Attribute Values: None

This dataset was obtained from the StatLib:
https://lib.stat.cmu.edu/datasets/houses.zip

The target variable is the median house value for California districts,
expressed in hundreds of thousands of dollars ($100,000).

This dataset was derived from the 1990 U.S. census, using one row per census
block group. A block group is the smallest geographical unit for which the U.S.
Census Bureau publishes sample data (a block group typically has a population
of 600 to 3,000 people).

A household is a group of people residing within a home. Since the average
number of rooms and bedrooms in this dataset are provided per household, these
columns may take surprisingly large values for block groups with few households
and many empty houses, such as vacation resorts.

It can be downloaded/loaded using the
:func:`sklearn.datasets.fetch_california_housing` function.由描述可以看到该数据集中含有20640个实例,每个实例包含八个属性:
| 属性名 | 属性信息 |
|---|---|
MedInc | 街区组的收入中位数 |
HouseAge | 街区组房屋年龄中位数 |
AveRooms | 每户平均房间数 |
AveBedrms | 每户平均卧室数 |
Population | 街区组人口 |
AveOccup | 平均每户人数 |
Latitude | 街区组所在纬度 |
Longitude | 街区组所在经度 |
目标值为加利福尼亚各区的房屋中位数价格,在这里采用留出法划分数据集,可以通过如下代码来训练线性回归模型并输出评估结果:
# 导入必要的库
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
from sklearn.datasets import fetch_california_housing # 一个经典的多变量数据集

california = fetch_california_housing()
df = pd.DataFrame(california.data, columns=california.feature_names)
df['MedHouseVal'] = california.target

# 特征
X = df.drop('MedHouseVal', axis=1)

# 目标值(房屋中位数价格)
y = df['MedHouseVal']

# 通过留出法划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# 创建并训练线性回归模型
model = LinearRegression()
model.fit(X_train, y_train)

# 使用测试集进行预测并评估模型性能
y_pred = model.predict(X_test)

mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f'MSE: {mse:.2f}')
print(f'R-squared: {r2:.2f}')可以看到线性回归模型的MSE约为\(0.53\),\(R^2\)为\(0.60\),可视化预测结果可以看到:
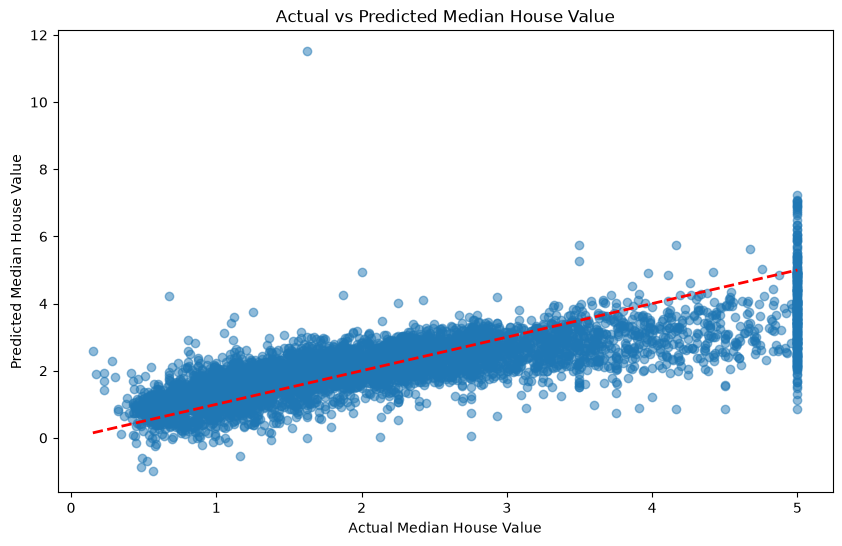
可视化特征重要性(参数的绝对值)可以看到:
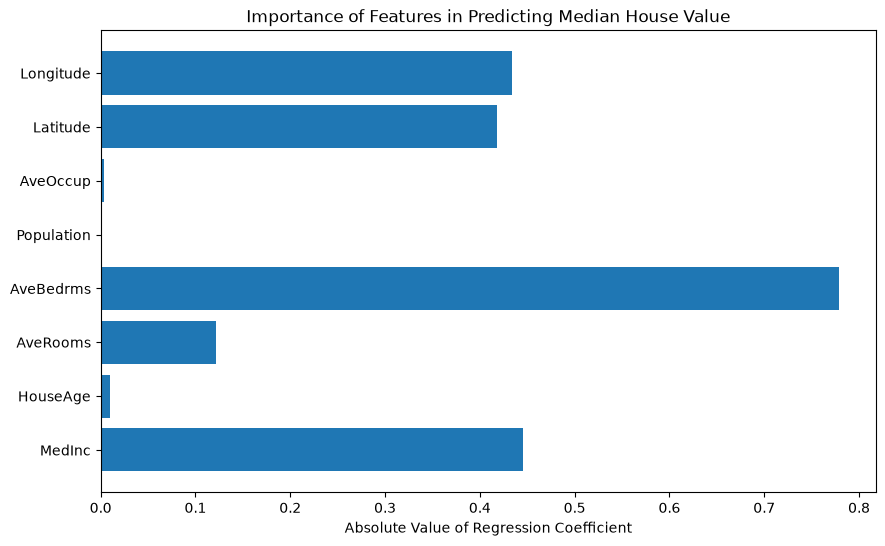
很明显,每户平均卧室数(AveBedrms)对房价的影响最大,街区组人口(Population)对房价的影响最小.
广义线性回归
已知线性回归模型:
\[
f(\pmb{x})=\pmb{w}^{T}\pmb{x}+b
\]
令\(f(\pmb{x})=\varphi(g(\pmb{x}))\)(其中\(\varphi(\cdot)\)为一个单调可微函数),可以得到:
\[
\varphi(g(\pmb{x}))=\pmb{w}^{T}\pmb{x}+b
\]
从而得到广义线性模型:
\[
g(\pmb{x})=\varphi^{-1}(\pmb{w}^{T}\pmb{x}+b)
\]
对数几率回归
对数几率回归模型主要用于二分类任务,即将输入分为两类(可以将输出标记简单地设为\(y\in\{0,1\}\),其中称结果为\(0\)的输入为反例,结果为\(1\)的输入为正例),最理想的情况为单位阶跃函数:
\[
\delta(x)=\begin{cases}
0&,x<0\\
\frac{1}{2}&,x=0\\
1&,x>0
\end{cases}
\]
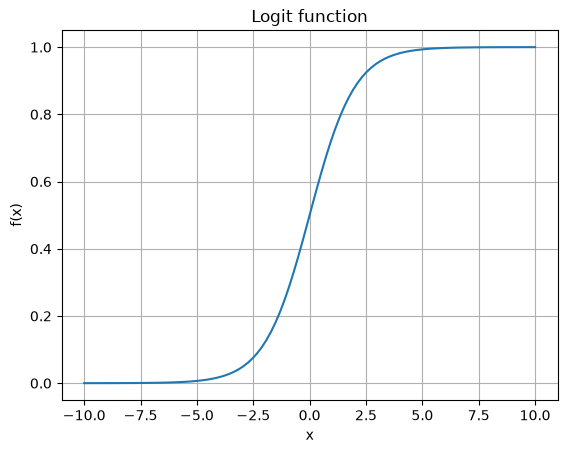
即当预测值为\(0\)时判为反例,预测值为\(1\)时判为正例,预测值为\(1/2\)时可任意判别,但是单位阶跃函数不连续,无法用于广义线性回归,所以一般采用对数几率函数进行近似替代:
\[
g(x)=\frac{1}{1+e^{-x}}
\]
该函数图像如下:
令\(\varphi(x)=g^{-1}(x)\)代入到广义线性回归中有:
\[
z=\varphi^{-1}(\pmb{w}^{T}\pmb{x}+b)=g(\pmb{w}^{T}\pmb{x}+b)=\frac{1}{1+e^{-(\pmb{w}^{T}\pmb{x}+b)}}
\]
可以得到:
\[
\ln{\frac{z}{1-z}}=\pmb{w}^{T}\pmb{x}+b
\]
很显然,\(z\)的取值范围为\((0,1)\),故可以将\(z\)视作样本\(\pmb{x}\)为正例的概率(记为\(p(y=1|\pmb{x})\)),那么可以知道\(1-z\)可以视作样本\(\pmb{x}\)为反例的概率(记为\(p(y=0|\pmb{x})\)),那么该式可以改写为:
\[
\ln{\frac{p(y=1|\pmb{x})}{p(y=0|\pmb{x})}}=\pmb{w}^{T}\pmb{x}+b
\]
显然可以知道:
\[
\begin{cases}
\frac{p(y=1|\pmb{x})}{p(y=0|\pmb{x})}=e^{\pmb{w}^{T}\pmb{x}+b}\
p(y=1|\pmb{x})+p(y=0|\pmb{x})=1
\end{cases}
\]
消去\(p(y=0|\pmb{x})\)可以得到:
\[
p(y=1|\pmb{x})+\frac{p(y=1|\pmb{x})}{e^{\pmb{w}^{T}\pmb{x}+b}}=\frac{p(y=1|\pmb{x})(e^{\pmb{w}^{T}\pmb{x}+b}+1)}{e^{\pmb{w}^{T}\pmb{x}+b}}=1
\]
从而可以得到:
\[
\begin{aligned}
&p(y=1|\pmb{x})=\frac{e^{\pmb{w}^{T}\pmb{x}+b}}{1+e^{\pmb{w}^{T}\pmb{x}+b}}\
&p(y=0|\pmb{x})=1-p(y=1|\pmb{x})=\frac{1}{1+e^{\pmb{w}^{T}\pmb{x}+b}}\
\end{aligned}
\]
对数据集\(D=\{(\pmb{x}_i,y_i)|i=1,2,\cdots,m\}\)可以通过最大似然估计法来估计\(\pmb{w}\)和\(b\),令\(\pmb{\beta}=\left(\begin{matrix}\pmb{w}\\b\end{matrix}\right),\hat{\pmb{x}}=\left(\begin{matrix}\pmb{x}\\1\end{matrix}\right)\),有:
\[
\pmb{w}^{T}\pmb{x}+b=\pmb{\beta}^{T}\hat{\pmb{x}}
\]
有似然函数:
\[
L(\pmb{\beta})=\prod_{i=1}^{m}p(y_i|\hat{\pmb{x}}_i;\pmb{\beta})
\]
取对数得:
\[
l(\pmb{\beta})=\ln{L(\pmb{\beta})}=\sum_{i=1}^{m}\ln{p(y_i|\hat{\pmb{x}}_i;\pmb{\beta})}=\sum_{i=1}^{m}\ln{[y_ip(y_i=1|\hat{\pmb{x}}_i;\pmb{\beta})+(1-y_i)p(y_i=0|\hat{\pmb{x}}_i;\pmb{\beta})]}
\]
从而可以得到:
\[
l(\pmb{\beta})=\sum_{i=1}^{m}\left[-y_i\pmb{\beta}^T\hat{\pmb{x}}_i+\ln{\left(1+e^{-\pmb{\beta}^T\hat{\pmb{x}}_i}\right)}\right]
\]
显然该函数关于\(\pmb{\beta}\)可导,那么可以通过求下述方程来得到参数\(\pmb{\beta}\):
\[
\frac{\partial l(\pmb{\beta})}{\partial\pmb{\beta}}=0
\]
这里以Iris数据集为例,该数据集的描述如下:
.. _iris_dataset:

Iris plants dataset
--------------------

**Data Set Characteristics:**

:Number of Instances: 150 (50 in each of three classes)
:Number of Attributes: 4 numeric, predictive attributes and the class
:Attribute Information:
    - sepal length in cm
    - sepal width in cm
    - petal length in cm
    - petal width in cm
    - class:
            - Iris-Setosa
            - Iris-Versicolour
            - Iris-Virginica

:Summary Statistics:

============== ==== ==== ======= ===== ====================
                Min  Max   Mean    SD   Class Correlation
============== ==== ==== ======= ===== ====================
sepal length:   4.3  7.9   5.84   0.83    0.7826
sepal width:    2.0  4.4   3.05   0.43   -0.4194
petal length:   1.0  6.9   3.76   1.76    0.9490  (high!)
petal width:    0.1  2.5   1.20   0.76    0.9565  (high!)
============== ==== ==== ======= ===== ====================

:Missing Attribute Values: None
:Class Distribution: 33.3% for each of 3 classes.
:Creator: R.A. Fisher
:Donor: Michael Marshall (MARSHALL%PLU@io.arc.nasa.gov)
:Date: July, 1988

The famous Iris database, first used by Sir R.A. Fisher. The dataset is taken
from Fisher's paper. Note that it's the same as in R, but not as in the UCI
Machine Learning Repository, which has two wrong data points.

This is perhaps the best known database to be found in the
pattern recognition literature.  Fisher's paper is a classic in the field and
is referenced frequently to this day.  (See Duda & Hart, for example.)  The
data set contains 3 classes of 50 instances each, where each class refers to a
type of iris plant.  One class is linearly separable from the other 2; the
latter are NOT linearly separable from each other.在这里我们只取sepal length和sepal width两个特征,并将该问题转换为二分类问题,之后通过sklearn的LogisticRegression类来进行训练:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.datasets import load_iris
from sklearn.metrics import accuracy_score

iris = load_iris()

# 简化问题
X = iris.data[:, :2]
y = np.where(iris.target == 0, 0, 1)

# 通过留出法划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# 建立对数几率回归模型并训练
model = LogisticRegression()
model.fit(X_train, y_train)

# 评估模型效果
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Accuracy: {accuracy:.2f}')可视化测试集的分类预测结果可以看到:
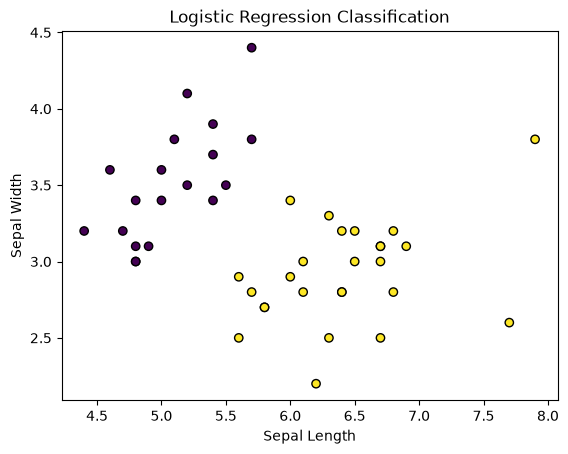
可以看到分类效果比较显著,由代码输出可知分类准确率为100%
决策树
决策树基于树结构来进行决策,一棵决策树包含一个根结点、若干个内部结点和若干个叶子结点,其中叶子结点对应决策的结果,而其它结点对应一个属性测试。每个结点包含的样本集合根据属性测试的结果被划分到子结点中,根节点包含样本全集,从根结点到每个叶子结点的路径对应一个判定测试序列,对于训练集\(D=\{(\pmb{x}_i,y_i)|i=1,2,\cdots,m\}\),属性集\(A=\{a_1,a_2,\cdots,a_d\}\),决策树的建树策略伪代码如下:
GenerateTree(D, A):
	生成结点node
	if D中样本全都属于同一类别C:
		将node标记为C类结点
	if A为空集或者D中的样本在A上的取值相同:
		将node标记为叶子结点默契类别标记为D中样本数最多的类
	从A中选择最优划分属性a0
	for a0的每个值a0i:
		为node生成一个分支
		令Dv表示D中在a0上取值为a0i的样本子集
		if Dv为空集:
			将分支结点标记为叶子结点,其类别标记为D中样本最多的类
		else:
			以GenerateTree(D, A-{a0})作为分支结点
返回以node为根节点的一棵决策树划分选择
在从A中选择最优划分属性a0这一步,我们希望决策树的分支结点所包含的样本尽可能属于同一类别,即结点的“纯度”越来越高,而样本集合的纯度一般由信息熵进行度量,对于训练集\(D\),设其中第\(k\)类样本所占的比例为\(p_k,k=1,2,\cdots,|\mathcal{Y}|\)(其中\(\mathcal{Y}\)为标记空间),则定义\(D\)之信息熵:
\[
\text{Ent}(D)=-\sum_{k=1}^{|\mathcal{Y}|}p_k\log_2{p_k}
\]
若\(p_k=0\),定义\(p_k\log_2{p_k}=0\)
很显然,\(\text{Ent}(D)\)越小,\(D\)的纯度越高。又假定离散属性\(a\)有\(V\)个可能的取值\({a^1,a^2,\cdots,a^V}\),若用\(a\)来对样本集\(D\)进行划分,会产生\(V\)个分支结点,其中第\(v\)个分支结点包含了\(D\)中所有在属性\(a\)上取值为\(a^v\)的样本,记为\(D^v\),可以定义用属性\(a\)对样本集\(D\)进行划分所得到的信息增益:
\[
\text{Gain}(D,a)=\text{Ent}(D)-\sum_{v=1}^V\frac{|D^v|}{|D|}\text{Ent}(D^v)
\]
信息增益\(\text{Gain}(D,a)\)越大,说明用属性\(a\)进行划分所获得的纯度提升越大,所以可以通过信息增益来进行决策树的划分属性选择。但是信息增益对可取值数目较多的属性有所偏好,为了减少这种偏好可能带来的不利影响,C4.5决策树算法引入增益率来选择最优化分属性,增益率定义如下:
\[
\text{Gain_ratio}(D,a)=\frac{\text{Gain}(D,a)}{\text{IV}(a)}
\]
其中:
\[
\text{IV}(a)=-\sum_{v=1}^{V}\frac{|D^v|}{|D|}\log_2\frac{|D^v|}{|D|}
\]
\(\text{IV}(a)\)称为属性值\(a\)的固有值,\(a\)的可能取值数目越多,\(\text{IV}(a)\)的取值一般就越大,此时\(\text{Gain_ratio}(D,a)\)通常不会很大,故在决策树的划分属性的选择这一步中,可以先找出候选划分属性中\(\text{Gain}(D,a)\)高于平均水平的划分属性,再从中选择\(\text{Gain_ratio}(D,a)\)最高的划分属性作为最优划分属性。
基尼指数(Gini index)
CART决策树采用基尼指数来选择划分属性,采用基尼值来度量数据集\(D\)的纯度:
\[
\text{Gini}(D)=\sum_{k=1}^{|\mathcal{Y}|}\sum_{k’\neq k}p_kp_{k’}=1-\sum_{k=1}^{|\mathcal{Y}|}p_k^2
\]
基尼值\(\text{Gini}(D)\)反映从数据集\(D\)中随机抽取两个样本,其类别标记不一致的概率,基尼值越小则说明数据集纯度越高,而对于属性\(a\),可以定义基尼指数如下:
\[
\text{Gini_index}(D,a)=\sum_{v=1}^{V}\frac{|D^v|}{|D|}\text{Gini}(D^v)
\]
可以利用基尼指数在候选划分属性集合中选择使得划分后基尼指数最小的划分属性作为最优划分属性.
剪枝处理
剪枝主要用去防止决策树的过拟合,基本策略有预剪枝和后剪枝两种:
预剪枝
预剪枝是在决策树生成过程中对每个结点在划分前进行估计,若当前结点的划分不能带来决策树泛化性能的提升则停止划分并将该结点标记为叶子结点.
后剪枝
后剪枝是在训练集完整生成决策树后自底向上地对非叶子结点进行考察,若将该结点对应的子树替换为叶子结点后,决策树的泛化性能提升就将该结点对应的子树替换为叶子结点.
泛化性能可以通过测试集的预测精度来衡量
连续值处理
对于连续属性,我们不可能像离散属性这样把每个取值拉出来划分,需要进行处理,在C4.5决策树算法中采用二分法来处理:
二分法
对于样本集\(D\)以及其中一个连续属性\(a\),假定\(a\)在\(D\)中出现了\(n\)个不同取值,将这\(n\)个值从小到大排序并记为\({a^1,a^2,\cdots,a^n}\),基于划分点\(t\)可以将\(D\)分为两个子集\(D^-_t\)和\(D^+_t\),其中\(D^-_t\)包含\(D\)中在属性\(a\)上取值不大于\(t\)的样本,\(D^+_t\)包含\(D\)中在属性\(a\)上取值大于\(t\)的样本,我们可以通过在如下集合上考察划分点:
\[
T_a=\left\{\frac{a^i+a^{i+1}}{2}|1\le i\le n-1\right\}
\]
基于划分点\(t\),我们可以将信息增益改写为:
\[
\text{Gain}(D,a,t)=\text{Ent}(D)-\sum_{\lambda\in\{-,+\}}\frac{|D^{\lambda}_t|}{|D|}\text{Ent}(D_t^\lambda)
\]
我们可以在\(T_a\)中选择\(\text{Gain}(D,a,t)\)最大的\(t\)作为划分点.
若当前节点划分属性为离散属性,该属性还可以作为其后代结点的划分属性
缺失值处理
若数据集中某些样本的部分属性值缺失,或者数据集中某些样本在划分属性上的属性值缺失,则没有办法进行正常的决策树训练或者预测,需要在训练时进行处理:
给定训练集\(D\)和属性\(a\),令\(\tilde{D}\)表示\(D\)中在属性\(a\)上没有缺失值的样本子集,在训练中我们可以直接用\(\tilde{D}\)来判断属性\(a\)的优劣,假定属性\(a\)有\(V\)个可取值\({a^1,a^2,\cdots,a^V}\),令\(\tilde{D}\)中在属性\(a\)上取值为\(a_v\)的子集为\(\tilde{D}^v\),\(\tilde{D}_k\)表示\(\tilde{D}\)中属于第\(k\)类(\(k=1,2,\cdots,|\mathcal{Y}|\))的样本子集,显然有:
\[
\bigcup_{k=1}^{|\mathcal{Y}|}\tilde{D}_k=\bigcup_{v=1}^{V}\tilde{D}^v=\tilde{D}
\]
假定给每个样本\(\pmb{x}\)赋予一个权重\(w_{\pmb{x}}\),并定义:
\[
\begin{aligned}
&\rho=\frac{\sum_{\pmb{x}\in\tilde{D}}w_{\pmb{x}}}{\sum_{\pmb{x}\in D}w_{\pmb{x}}},\\
&\tilde{p}_k=\frac{\sum_{\pmb{x}\in\tilde{D}_k}w_{\pmb{x}}}{\sum_{\pmb{x}\in \tilde{D}}w_{\pmb{x}}}(1\le k\le|\mathcal{Y}|),\\
&\tilde{r}_v=\frac{\sum_{\pmb{x}\in\tilde{D}^v}w_{\pmb{x}}}{\sum_{\pmb{x}\in \tilde{D}}w_{\pmb{x}}}(1\le v\le V)
\end{aligned}
\]
可以看到,对于属性\(a\),\(\rho\)表示无缺失样本占总样本的比例,\(\tilde{p}_k\)表示无缺失样本中第\(k\)类所占的比例,\(\tilde{r}v\)表示无缺失样本中在\(a\)上取值为\(a^v\)所占的比例,可以推广出有缺失值的数据集的信息增益为:
\[
\text{Gain}(D,a)=\rho\times\text{Gain}(\tilde{D},a)=\rho\times\left(\text{Ent}(\tilde{D})-\sum{v=1}^V\text{Ent}(\tilde{D}^v)\right)
\]
其中\(\tilde{D}\)的信息熵由下式计算:
\[
\text{Ent}(\tilde{D})=-\sum_{k=1}^{|\mathcal{Y}|}\tilde{p}_k\log_2\tilde{p}_k
\]
利用这样的决策树进行样本预测的时候,若样本\(\pmb{x}\)在\(a\)上无缺失值,则将\(\pmb{x}\)直接划入对应子结点,且样本权值在该子结点中保持为\(w_{\pmb{x}}\),若样本\(\pmb{x}\)在\(a\)上取值缺失,则将\(\pmb{x}\)划入所有子结点,且样本权值在属性值\(a^v\)对应的子结点处为\(\tilde{r}_vw_{\pmb{x}}\).
实例
以Iris数据集为例,可以通过如下代码进行训练并测试准确率:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split
from sklearn.datasets import load_iris
from sklearn.metrics import accuracy_score

# 加载Iris数据集
iris = load_iris()

# 划分特征和标签
df = pd.DataFrame(data=iris.data, columns=iris.feature_names)
y = iris.target

# 通过留出法划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(df, y, test_size=0.3, random_state=42)

# 创建决策树分类器
clf = DecisionTreeClassifier(random_state=42)

# 训练模型
clf.fit(X_train, y_train)

# 在测试集上进行预测
y_pred = clf.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
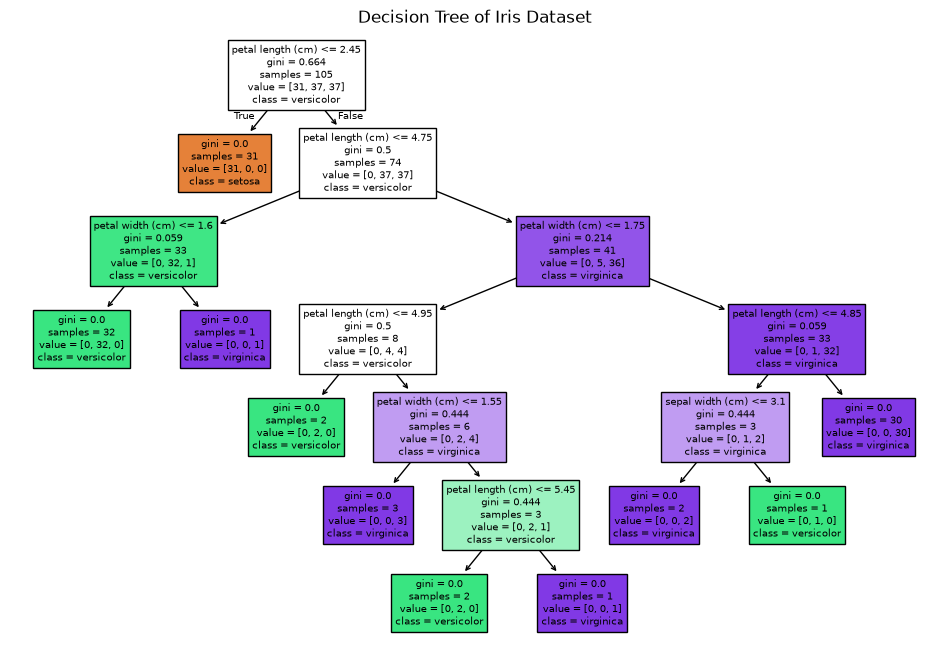
print(f"模型在测试集上的准确率: {accuracy:.2f}")可视化决策树可以看到:
神经网络
神经元模型
神经网络是由具有适应性的简单单元组成的广泛并行互连的网络,它的组织可以模拟生物神经系统对真实物体所作出的交互反应,神经元模型是神经网络最基本的成分,神经元模型可以由如下M-P神经元模型进行描述:
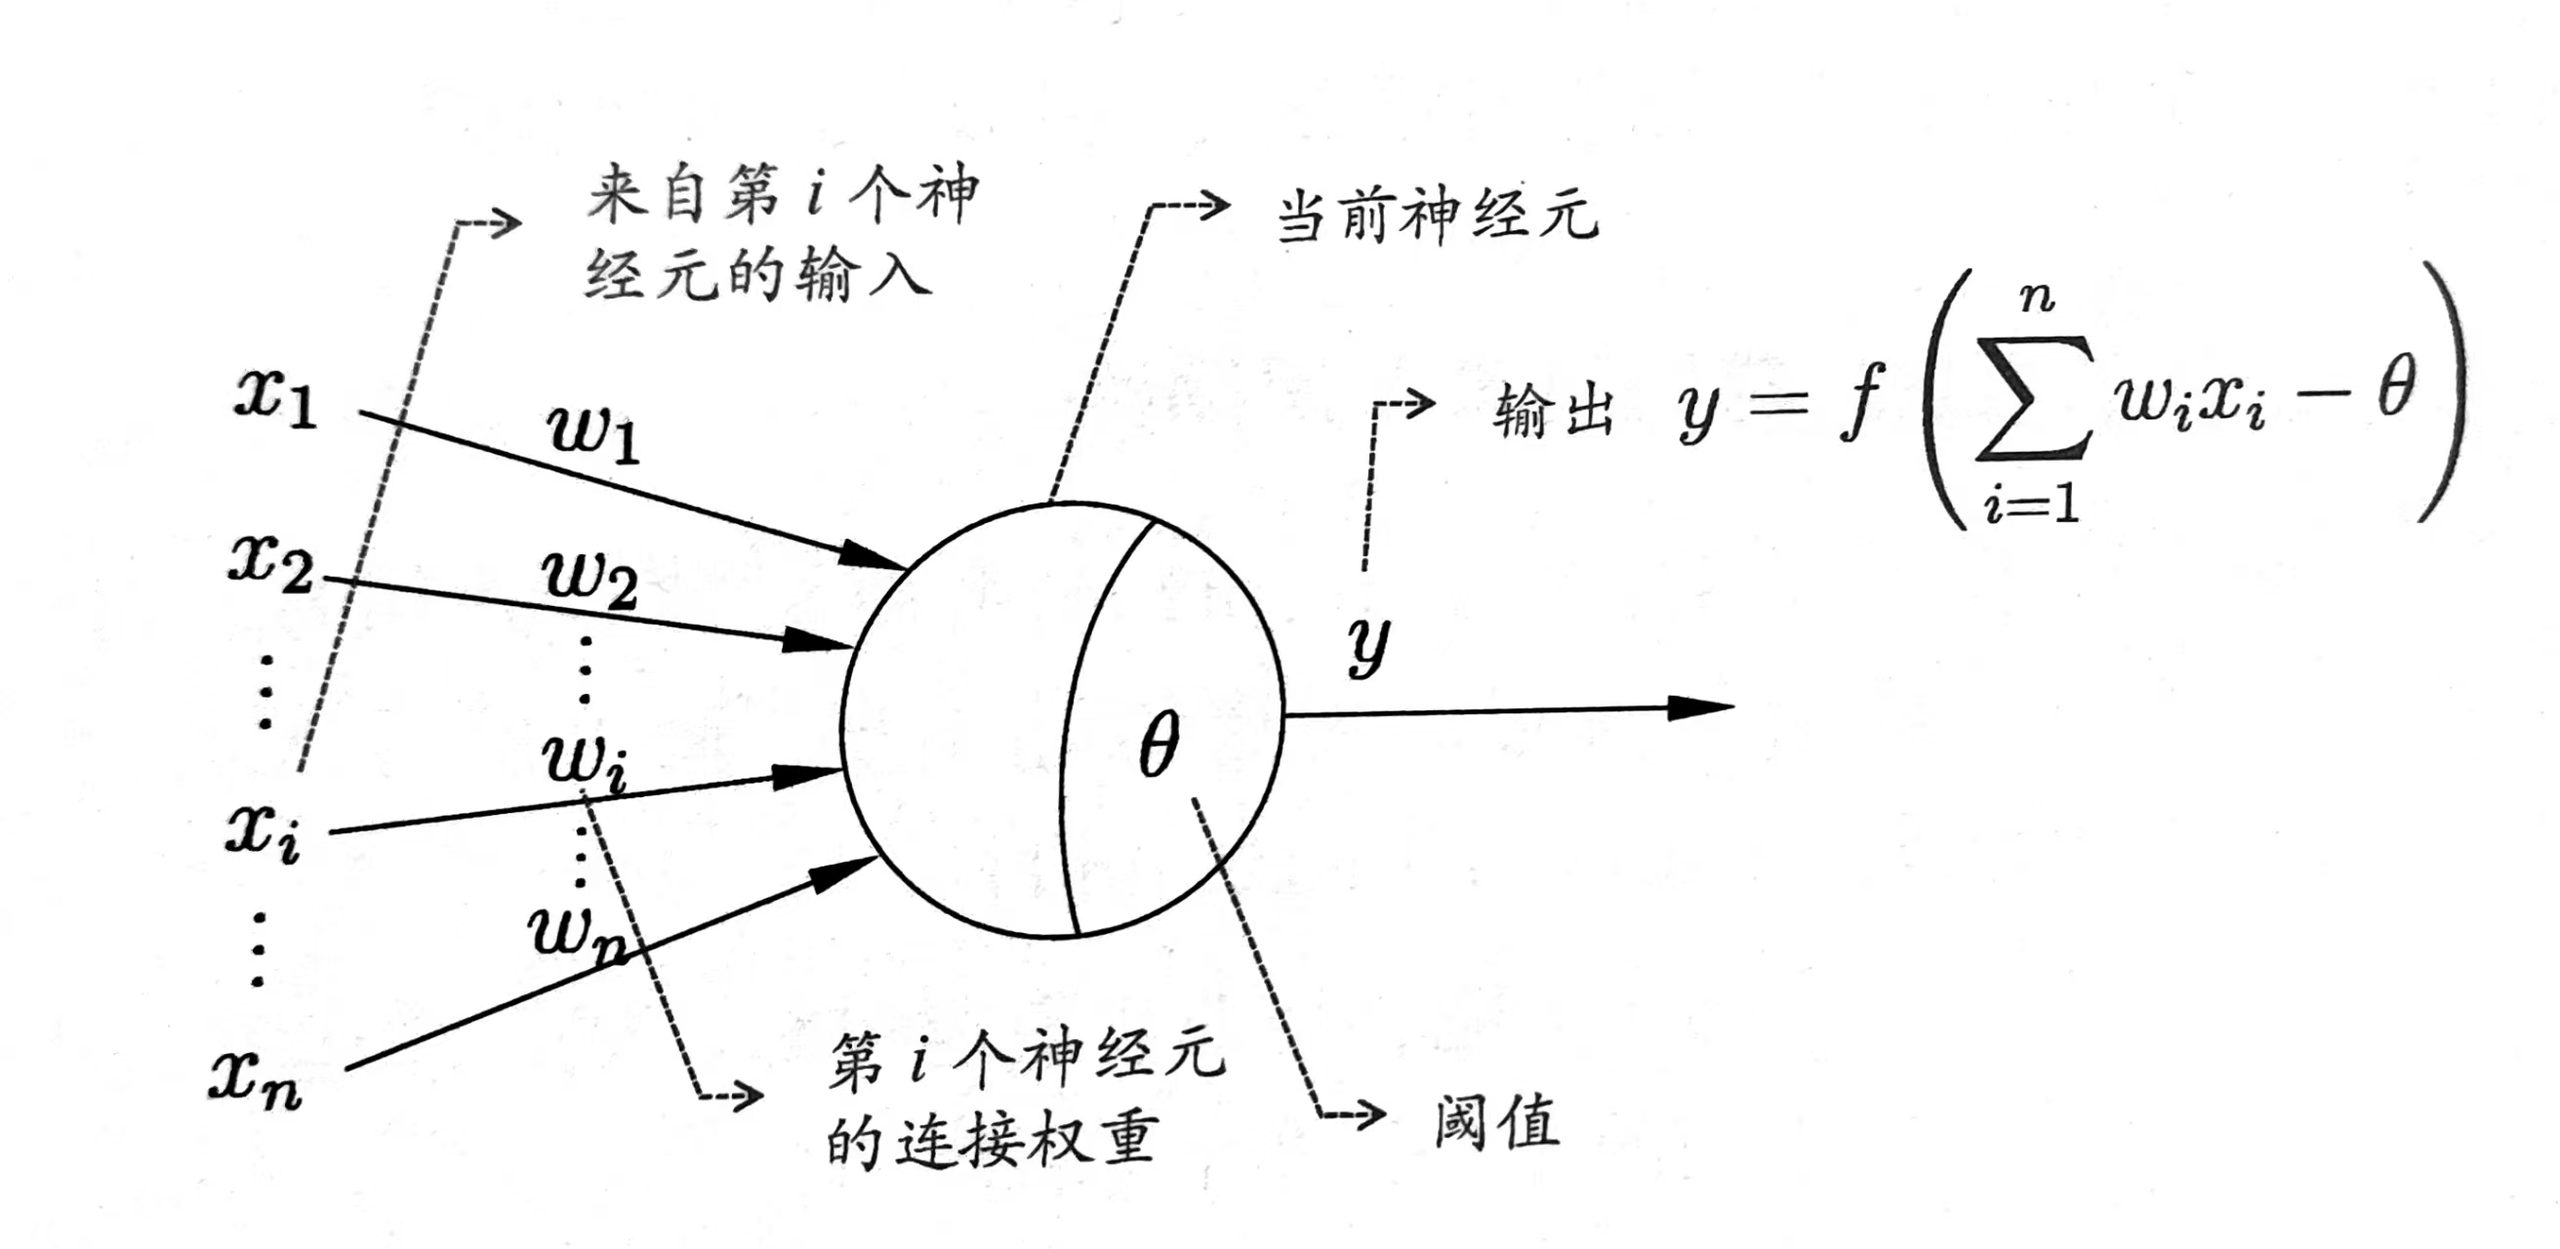
在这个模型中,一个神经元会接受\(n\)个来自其它神经元传递过来的输入信号,这些信号通过带权重的连接进行传递,神经元接收到的总输入值将与神经元的阈值进行比较,然后通过激活函数处理以产生神经元的输出,例如对于\(n\)个输入信号\(x_1,x_2,\ldots,x_{n}\),它们对应的连接权重分别为\(w_1,w_2,\ldots,w_{n}\),阈值为\(\theta\),激活函数为\(f\),则该神经元的输出为:
\[
y=f\left(\sum_{i=i}^{n}w_ix_i-\theta\right)
\]
其中激活函数\(f\)常用Sigmoid函数\(f=\frac{1}{1+e^{-x}}\).
将多个神经元按一定层次结构组合起来就得到了神经网络.
感知机
感知机由两层神经元组成,其中输入层接收外界输入信号后传递给输出层,输出层则是M-P神经元,对输入层传递过来的输入信号进行处理后得到输出。
而对给定训练集,权重\(w_i(i=1,2,\cdots,n)\)以及阈值\(\theta\)可以通过学习得到,因为神经元的输出为:
\[
y=f\left(\sum_{i=i}^{n}w_ix_i-\theta\right)
\]
所以我们可以将阈值\(\theta\)视作输出固定为\(x_{n+1}=-1\)的哑结点,连接权重为\(w_{n+1}\),那么我们可以将神经元的输出改写为:
\[
y=f\left(\sum_{i=i}^{n+1}w_ix_i\right)
\]
这样我们就可以将权重和阈值的学习统一为权重的学习,学习过程如下:对训练样例\((\pmb{x},y)\),若当前的输出为\(\hat{y}\),则调整权重:
\[
w_{i}\leftarrow w_{i}+\eta(y-\hat{y})x_i
\]
其中\(\eta\in(0,1)\)称为学习率。
而感知机的学习能力非常有限,若两类模式是线性可分(即存在一个线性超平面将两类模式分开)的,则感知机的学习过程一定会收敛(即可以求得适当的权重\(w_1,w_2,\ldots,w_{n+1}\));若非线性可分的则感知机学习过程则会振荡(即权重\(w_1,w_2,\ldots,w_{n+1}\)难以稳定),为解决非线性可分问题,需要考虑使用多层功能神经元(即在输入层和输出层之间加入多个隐层)。
神经网络
最常见的神经网络为多层前馈神经网络,即每层神经元与下一层的神经元全互连,神经元之间不存在跨层连接:
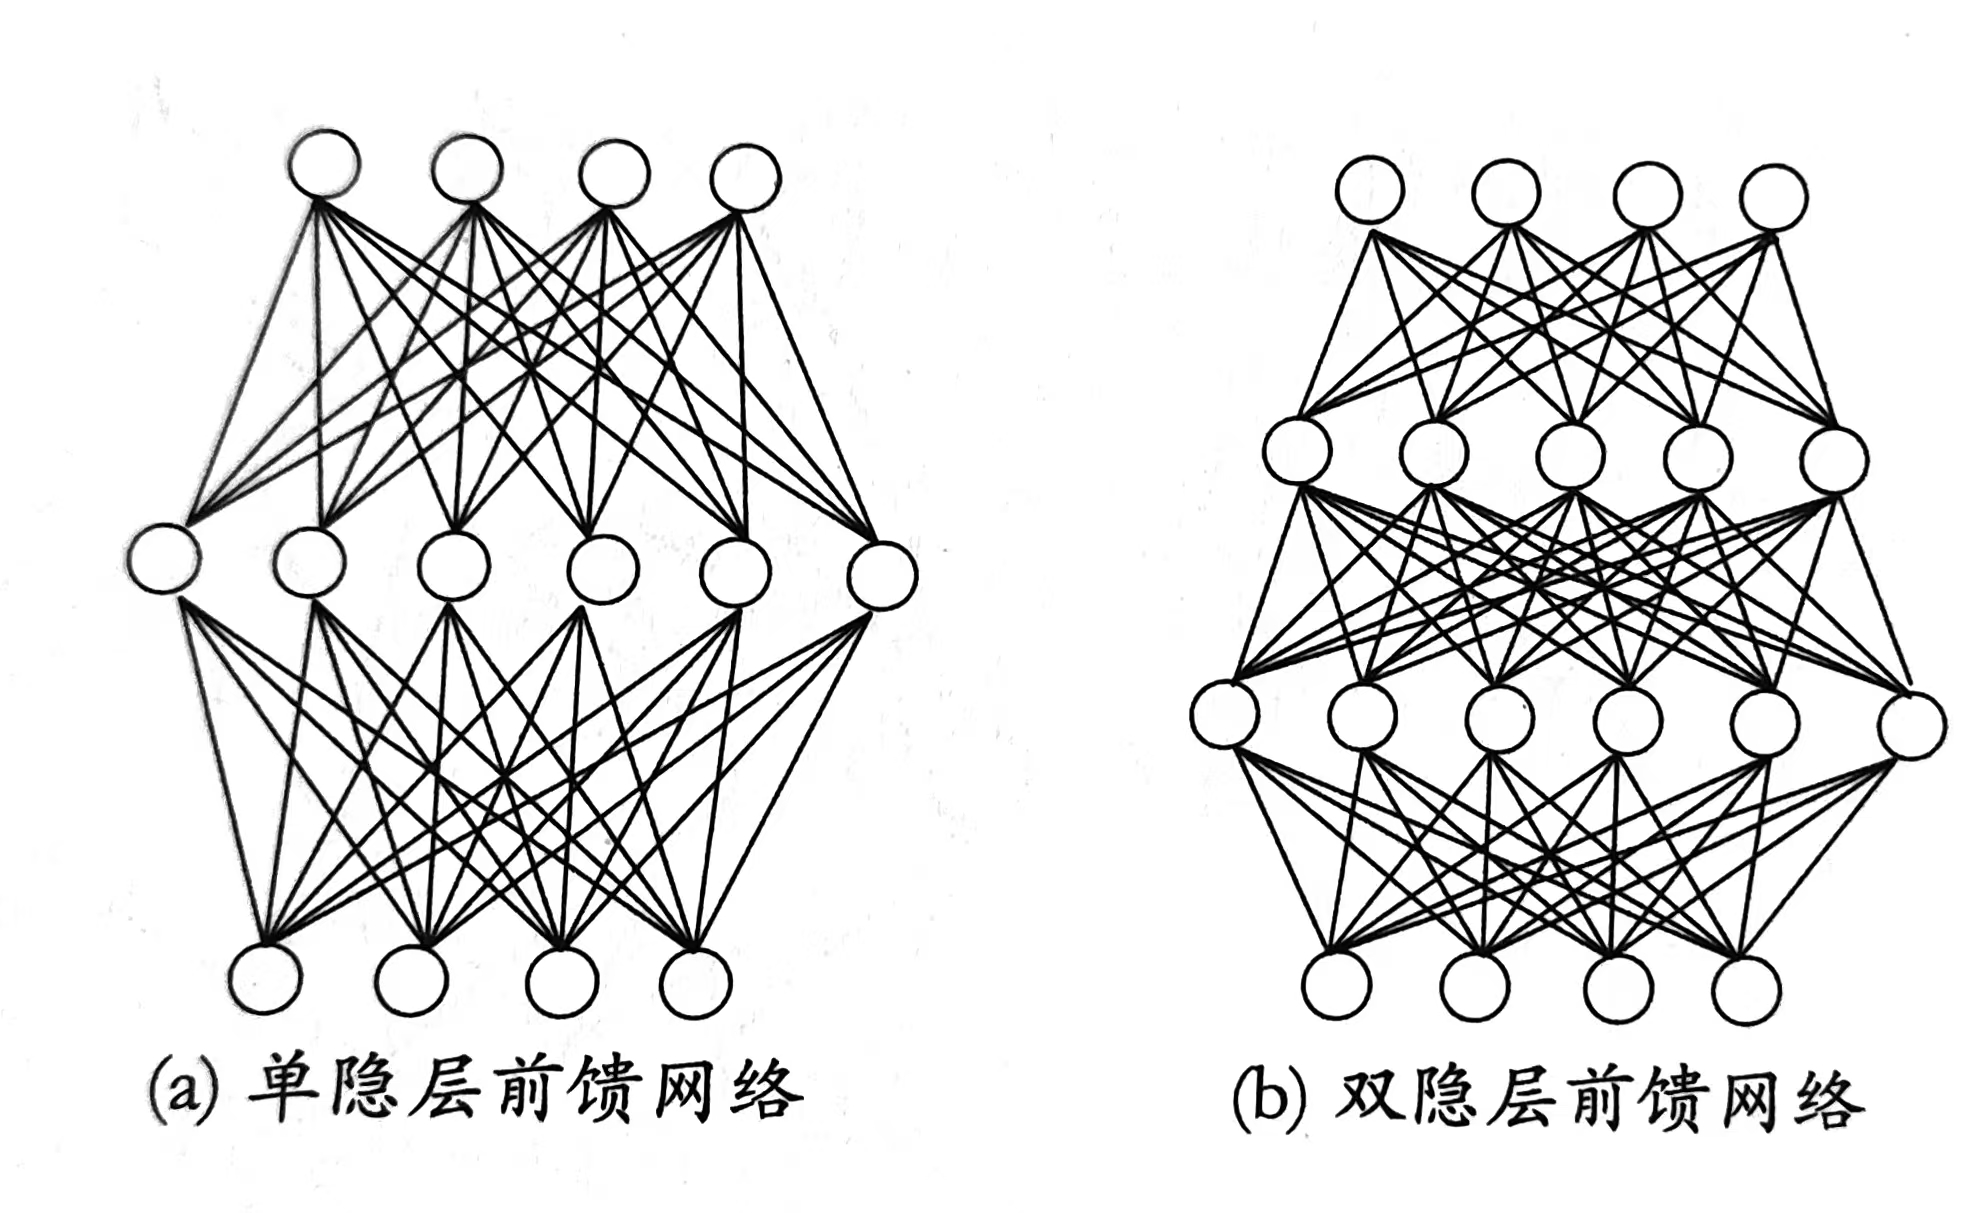
其中输入层神经元接收外界输入,隐层和输出层神经元则对信号进行加工,最终结果则由输出层神经元输出。神经网络的学习过程就是根据训练数据来调整神经元之间的连接权重以及每个M-P神经元的阈值,详细的训练过程分如下几步:
- 前向传播:输入训练数据通过多层计算后得到预测输出
- 计算损失:通过损失函数衡量预测输出与预期输出的差距
- 反向传播:计算所有权重对误差的影响
- 更新权重:通过优化算法调整权重和阈值
- 重复迭代:使用其它训练数据重复上述步骤
误差逆传播算法(BP算法)
常用误差逆传播算法(BP算法)对多层前馈神经网络进行训练,以单隐层前馈网络为例,算法流程如下:
给定训练集\(D=\{(x_i,y_i)|i=1,2,\cdots,m\}\),其中\(x_i\in\mathbb{R}^d,y_i\in\mathbb{R}^l\)(即输入示例由\(d\)个属性描述,输出\(l\)维实值函数),设输出层第\(j\)个神经元阈值为\(\theta_j\),隐层第\(h\)个神经元阈值为\(\gamma_h\),输入层第\(i\)个神经元与隐层第\(h\)个神经元的连接权为\(v_{ih}\),隐层第\(h\)个神经元与输出层第\(j\)个神经元的连接权为\(w_{hj}\)并记隐层第\(h\)个神经元的输入为:
\[
\alpha_h=\sum_{i=1}^{d}v_{ih}x_{i}
\]
隐层第\(h\)个神经元的输出为\(b_h\);输出层第\(j\)个神经元接收到的输入为:
\[
\beta_{j}=\sum_{h=1}^{l}w_{hj}b_h
\]
并且设输出层和隐层都使用Sigmoid函数,则对第\(k\)个训练示例\((x_k,y_k)\)。假定神经网络的输出为\(\hat{y}_k=(\hat{y}_1^{k},\hat{y}_2^{k},\ldots,\hat{y}_l^{k})\),有:
\[
\hat{y}_{j}^k=f(\beta_j-\theta{j})=f\left(\sum_{h=1}^{l}w_{hj}b_h-\theta_j\right)
\]
则有均方误差:
\[
E_k=\frac{1}{2}\sum_{j=1}^{l}(\hat{y}_{j}^k-y_{j}^k)^2
\]
BP算法采用梯度下降策略来设法降低\(E_k\),并且会根据类似感知机的学习规则进行更新权重调整,对于给定学习率,有:
\[
\Delta w_{hj}=-\eta\frac{\partial E_k}{\partial w_{hj}}
\]
根据传播流程可以知道\(w_{hj}\)会先影响第\(j\)个输出层神经元的输入值\(\beta_{j}\),再影响输出值\(\hat{y}^{k}_j\),最后影响到均方误差\(E_k\),所以有:
\[
\frac{\partial E_k}{\partial w_{hj}}=\frac{\partial E_k}{\partial \hat{y}^{k}_j}\cdot\frac{\partial \hat{y}^{k}_j}{\partial \beta_{j}}\cdot\frac{\partial \beta_{j}}{\partial w_{hj}}
\]
而\(\beta_{j}=\sum_{h=1}^{l}w_{hj}b_h\),所以有\(\frac{\partial \beta_{j}}{\partial w_{hj}}=b_h\),那么可以知道:
\[
\Delta w_{hj}=-\eta\frac{\partial E_k}{\partial w_{hj}}=-\eta\frac{\partial E_k}{\partial \hat{y}^{k}_j}\cdot\frac{\partial \hat{y}^{k}_j}{\partial \beta_{j}}\cdot\frac{\partial \beta_{j}}{\partial w_{hj}}=-\eta b_{h}\frac{\partial E_k}{\partial \hat{y}^{k}_j}\cdot\frac{\partial \hat{y}^{k}_j}{\partial \beta_{j}}
\]
而对于Sigmoid函数\(f(x)=\frac{1}{1+e^{-x}}\),有:
\[
f'(x)=\frac{e^{-x}}{(1+e^{-x})^2}=\frac{1}{1+e^{-x}}\cdot\frac{e^{-x}}{1+e^{-x}}=f(x)(1-f(x))
\]
那么有:
\[
g_j=-\frac{\partial E_k}{\partial \hat{y}^{k}_j}\cdot\frac{\partial \hat{y}^{k}_j}{\partial \beta_{j}}=-(\hat{y}_{j}^k-y_{j}^k)f'(\beta_j-\theta_j)=(y_{j}^k-\hat{y}_{j}^k)\hat{y}_{j}^k(1-\hat{y}_{j}^k)
\]
从而有:
\[
\Delta w_{hj}=-\eta\frac{\partial E_k}{\partial w_{hj}}=-\eta b_hg_j
\]
那么我们可以得到权重\(w_{hj}\)的更新公式:
\[
w_{hj}\leftarrow w_{hj}+\Delta w_{hj}
\]
即:
\[
w_{hj}\leftarrow w_{hj}+\eta b_h g_j
\]
同理可以得到:
\[
\begin{aligned}
&\Delta\theta_{j}=-\eta g_j\\
&\Delta v_{ih}=\eta x_i e_h\\
&\Delta \gamma_h=-\eta e_h
\end{aligned}
\]
其中:
\[
e_h=b_h(1-b_h)\sum_{j=1}^lw_{hj}g_j
\]
学习率\(\eta\in(0,1)\)控制着算法每轮迭代的更新步长,不同层的学习率可以不同,BP算法的最终目标是最小化训练集\(D\)上的累计误差:
\[
E=\frac{1}{m}\sum_{k=1}^m E_k
\]
实例
使用PyTorch训练一神经网络用于对MNIST数据集进行分类并使用测试集进行测试:
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"

import matplotlib
%matplotlib inline
import matplotlib.pyplot as plt

import torch
from torch import nn, optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 导入 MNIST 数据集
transform = transforms.ToTensor()
train_dataset = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)

# 定义一个简单的神经网络模型
model = nn.Sequential(
    nn.Flatten(),
    nn.Linear(28 * 28, 256),
    nn.Sigmoid(),
    nn.Linear(256, 10)
).to(device)

# 定义损失函数和优化器
loss_fn = nn.CrossEntropyLoss() # 交叉熵
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # 随机梯度下降优化器,学习率=0.01

for epoch in range(5):  # 迭代5次
    for x, y in train_loader:
        x, y = x.to(device), y.to(device)

        # 前向传播
        predictions = model(x)
        loss = loss_fn(predictions, y)

        # 反向传播和优化
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    print(f"Epoch {epoch + 1}, Loss: {loss.item():.4f}")

# 可视化预测
dataiter = iter(train_loader)
images, labels = next(dataiter)
outputs = model(images.to(device))

_, predicted = torch.max(outputs, 1)

fig, axes = plt.subplots(1, 6, figsize=(12, 2))
for i in range(6):
    axes[i].imshow(images[i].squeeze(), cmap='gray')
    axes[i].set_title(f'Pred: {predicted[i].item()}')
    axes[i].axis('off')
plt.show()可以看到测试结果如下:
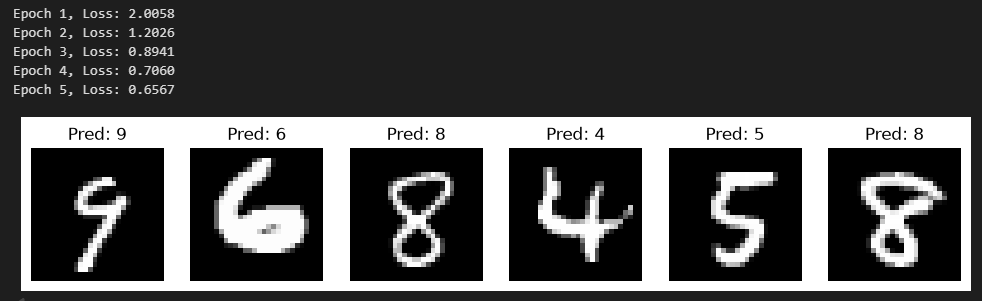
其中神经网络模型的定义如下:
model = nn.Sequential(
    nn.Flatten(),
    nn.Linear(28 * 28, 256),
    nn.Sigmoid(),
    nn.Linear(256, 10)
).to(device)其中第一行的nn.Flatten()表示将二维图像展平成一维向量,nn.Linear(28 * 28, 256)表示一个28\times28维(即图片大小)的输入压缩为256维的输出的隐藏层,nn.Sigmoid()表示使用Sigmoid函数作为隐藏层的激活函数,nn.Linear(256, 10)表示一个将256维输入压缩为10维输出的输出层.
常用激活函数
Sigmoid
\[
\text{Sigmoid}(x) = \frac{1}{1+e^{-x}}
\]
tanh
\[
\tanh(x)=\frac{e^{x}-e^{-x}}{e^x+e^{-x}}
\]
ReLU
\[
\text{ReLU}(x)=\max(0,x)
\]
Leaky ReLU
\[
\text{LeakyReLU}(x)=\max(\alpha x,x)
\]
\(\alpha\)固定,一般取\(\alpha=0.01\)
PReLU
\[
\text{PReLU}(x)=\max(\alpha x, x)
\]
\(\alpha\)为可学习参数
Softmax(用于多分类学习的输出层)
\[
\text{Softmax}(x_i)=\frac{e^{x_i}}{\sum_{j}e^{x_j}}
\]
卷积神经网络
卷积神经网络 (Convolutional Neural Networks, CNN) 是一类专门用于处理具有网格状拓扑结构数据(如图像)的深度学习模型,其包括如下几种层:
- 卷积层
- 激活层
- 归一化层
- 池化层
- 全连接层
- 输出层
卷积层
卷积层利用卷积核提取局部特征,对于输入矩阵\(x\),卷积核\(k\),以及偏置\(b\),卷积层的输出为一个矩阵\(y\),其中:
\[
y[i,j]=\sum_{m}\sum_{n}x[i+m,j+n]k[m,n]+b
\]
例如对于如下矩阵:
\[
x=\left(\begin{matrix}
0&1&2\\3&4&5\\6&7&8
\end{matrix}\right),
k=\left(\begin{matrix}
0&1\\2&3
\end{matrix}\right)
\]
以及偏置\(b=2\),有:
\[
\begin{aligned}
y[0,0]=\sum_{m=0}^1\sum_{n=0}^1x[0+m,0+n]k[m,n]+b=0\times0+1\times1+3\times2+4\times3+2=21\\
y[0,1]=\sum_{m=0}^1\sum_{n=0}^1x[0+m,1+n]k[m,n]+b=1\times0+2\times1+4\times2+5\times3+2=27\\
y[1,0]=\sum_{m=0}^1\sum_{n=0}^1x[1+m,0+n]k[m,n]+b=3\times0+4\times1+6\times2+7\times3+2=39\\
y[1,1]=\sum_{m=0}^1\sum_{n=0}^1x[1+m,1+n]k[m,n]+b=4\times0+5\times1+7\times2+8\times3+2=45
\end{aligned}
\]
可以得到:
\[
y=\left(\begin{matrix}
21&27\\39&45
\end{matrix}\right)
\]
在卷积层中,卷积核和偏置是需要学习的.
激活函数
一般在卷积层之后会应用非线性激活函数,用于引入非线性特征,常用ReLU函数
归一化层
归一化层一般用于对中间特征做统计标准化,让训练更稳定、更快,常用的方法是批归一化(Batch Norm,简称BN),对于一组输入,该方法会对一组输入特征图中每个通道的特征\(x\)做如下计算:
\[
y_i=\gamma \frac{x_i-\mu}{\sqrt{\sigma^2+\varepsilon}}+\beta
\]
其中\(\mu\)为这组输入在该通道上的均值,\(\sigma^2\)为这组输入在该通道上的方差,\(\gamma\)以及\(\beta\)则分别为需要学习的缩放参数以及平移参数
池化层
池化层一般用于降低特征图的空间维度,以减少计算量,一般对特征图的每个通道都进行池化,池化方法主要有如下两种:
- 最大池化:提取待池化窗口内的最大值
- 平均池化:计算待池化窗口内的平均值
经池化后宽高会变小,通道数不变
全连接层
与多层感知机的一般隐层无异,对于输入向量\(x\),权重矩阵\(W\)以及偏置\(b\),采用激活函数\(f\)得到的输出为:
\[
y=f(Wx+b)
\]
在CNN中,全连接层和前面的层之间必须要加一步展平操作将特征图展平为一个一维向量。
CNN一般结构
CNN的典型结构一般为:
\[
\text{输入}\rightarrow[\text{卷积}\rightarrow\text{激活}\rightarrow\text{池化}]\times N\rightarrow\text{展平}\rightarrow[\text{全连接}\rightarrow\text{激活}]\times M\rightarrow\text{输出}
\]
更常用的结构为:
\[
\text{输入}\rightarrow[\text{卷积}\rightarrow\text{归一化}\rightarrow\text{激活}]\times N\rightarrow\text{全局平均池化}\rightarrow\text{全连接}\rightarrow\text{Softmax}
\]
CNN训练例——MNIST分类
以简化版LeNet-5模型为例,该模型的结构如下:
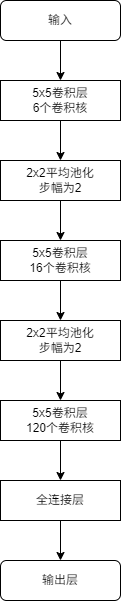
其中第一个卷积层需要将\(28\times28\)的输入填充到\(32\times32\),而全连接层包含两个隐层。进行十轮训练并进行预测的代码如下:
import os
os.environ['KMP_DUPLICATE_LIB_OK'] = 'True'

import torch
from torch import nn, optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
import matplotlib.pyplot as plt

EPOCHS = 5
LEARNING_RATE = 0.0001
TEST_NUM = 10

transform = transforms.ToTensor()
MNIST_data = datasets.MNIST(root="D:\\AI Security\\data", train=True, download=True, transform=transform)
data_loader = DataLoader(MNIST_data, batch_size=64, shuffle=True)

LeNet5 = nn.Sequential(
    nn.Conv2d(1, 6, kernel_size=5, stride=1, padding=2),
    nn.Tanh(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Conv2d(6, 16, kernel_size=5, stride=1),
    nn.Tanh(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Flatten(),
    nn.Linear(16 * 5 * 5, 120),
    nn.Tanh(),
    nn.Linear(120, 84),
    nn.Tanh(),
    nn.Linear(84, 10)
)

loss_function = nn.CrossEntropyLoss()
optimizer = optim.Adam(LeNet5.parameters(), lr=LEARNING_RATE)

losses = []

for epoch in range(EPOCHS):
    for batch_idx, (data, target) in enumerate(data_loader):
        optimizer.zero_grad()
        output = LeNet5(data)
        loss = loss_function(output, target)
        loss.backward()
        optimizer.step()

    print(f'Epoch {epoch + 1}/{EPOCHS}, Loss: {loss.item()}')
    losses.append(loss.item())

# 可视化预测结果
data, target = next(iter(data_loader))
output = LeNet5(data)

_, predicted = torch.max(output, 1)

fig, axes = plt.subplots(1, TEST_NUM, figsize=(TEST_NUM * 2, 2))
for i in range(TEST_NUM):
    axes[i].imshow(data[i][0], cmap='gray')
    axes[i].set_title(f'Pred: {predicted[i].item()}\nTrue: {target[i].item()}')
    axes[i].axis('off')
plt.show()

# 可视化损失
plt.plot(range(1, EPOCHS + 1), losses)
plt.xlabel('Epochs')
plt.ylabel('Loss')
plt.title('Training Loss over Epochs')
plt.show()预测结果如下:
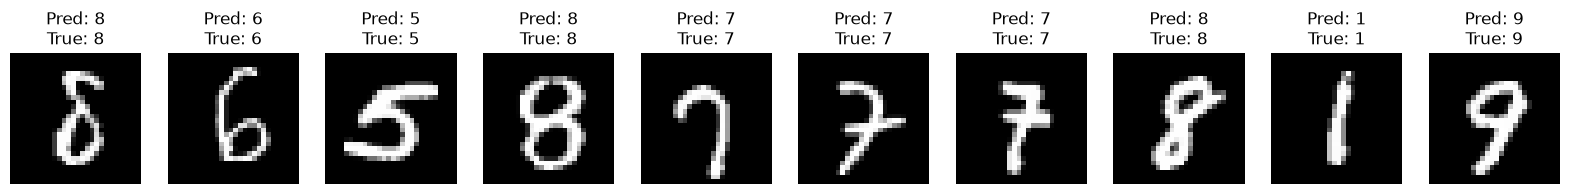
可以看到预测效果较好.
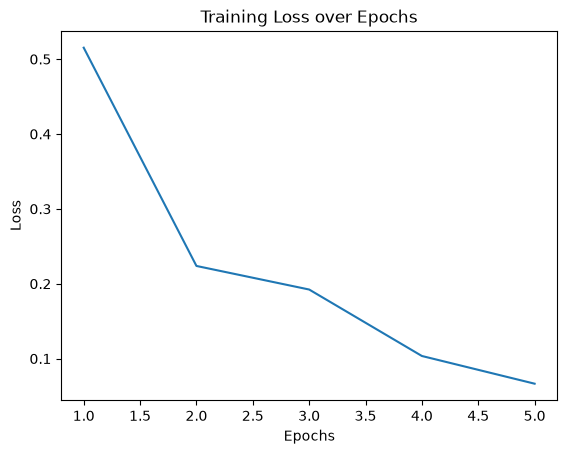
损失下降曲线如下: